How Multi-Agent Architecture Makes Enterprise AI Workflows More Reliable
內容目錄
哪來的自信
請同一個 AI 寫完一份報告,再請它檢查這份報告有沒有錯。
常常會得到一句「內容正確,沒有發現問題」。我都會問它哪來的自信….哈
原因很單純,它的上下文裡全是自己剛才的推理,自然會認同自己,不少團隊做 AI Agent 的第一版,就是讓一個 Agent 同時查資料、算數字、寫報告,還要檢查自己。Demo 時看起來很省事,上線一個月後開始出狀況…回答變慢、費用變高、錯了也找不到原因。
這篇整理三件事…
- 單一 Agent 在複雜任務裡容易卡在哪
- Multi-Agent 怎麼用訊息與狀態把工作拆開
- 拆開之後,哪些新麻煩要先想好
一句名詞解釋…Multi-Agent(多Agent協作架構) 是讓多個各有專長與權限的 AI Agent,透過共用狀態與訊息分工,共同完成一項任務的系統架構。
一個 Agent 什麼都做,問題出在哪?
任務簡單時,一個模型加幾個工具就夠用。任務變複雜之後,下面幾個狀況很常出現。
1. Token越用越多
單一 Agent 要把所有規則、所有工具說明和完整對話歷史一起帶著跑,每一輪推論都重送一次。工具越多,說明文字佔掉的上下文越多,留給真正任務的空間越少,費用也跟著上升。
2. 指令互相打架
同一份指令一邊要求「嚴格挑錯,寧可誤殺」,一邊要求「大膽發想,不要設限」,模型只能折衷。同一個 Agent 既當嚴格的 Code Reviewer,又當創意的文案發想者,常見結果是挑錯不夠狠,創意也不夠野。
3. 自己檢查自己
寫程式的 Agent 回頭檢查自己寫的程式,上下文裡全是自己的推理,很容易認同自己前面的判斷。自己出題又自己改考卷,抓不到幾個錯。
4. 工具與權限一起膨脹
工具一多,選錯工具、填錯參數的機率通常跟著上升。同一個 Agent 同時握有讀資料庫、寫檔案、寄信的權限,任何一次誤判的影響範圍就是整套系統。
5. 出錯很難找
輸出錯了,整條推理混在同一段對話裡。資料抓錯、計算錯,還是寫報告時自己編了內容,往往要整段重讀才知道。
| 問題 | 單一 Agent 的狀況 | 拆開後的做法 |
|---|---|---|
| Token消耗 | 全部規則與工具每輪重送 | 每個 Agent 只帶自己需要的上下文 |
| 指令衝突 | 挑錯與發想互相拉扯 | 不同角色使用不同指令 |
| 自我檢查 | 抓不到自己的盲點 | 由獨立的 Agent 稽核 |
| 工具與權限 | 選錯工具,誤判影響全系統 | 每個 Agent 只配少數工具與最小權限 |
| 除錯 | 錯誤混在同一段推理裡 | 逐步記錄,每一步可追蹤 |
拆開不一定比較好。任務單純時,單一 Agent 反而更省,拆分是複雜度到了某個程度才值得付出的代價。要不要拆,可以先問這幾件事…
- 任務裡有沒有互相衝突的指令,嚴格挑錯與大膽發想就是一組
- 有沒有需要獨立檢查的環節
- 工具與權限是不是已經多到難以管理
- 出錯時,能不能知道錯在哪一步
多數都答得出「有」,才輪到拆分。
Multi-Agent 怎麼協作?先看訊息與狀態

一個 Agent 可以拆成四個部分…模型、指令、工具與權限。Multi-Agent 要運作,靠兩件事…訊息怎麼傳,狀態怎麼記。
一句名詞解釋…狀態管理(State Management)是記錄任務目前的進度、已完成的步驟與中間結果,讓每個 Agent 接手時知道前面發生過什麼的機制。
訊息傳遞有幾個常見做法。
- Agent 之間少用長篇自然語言轉述,改用固定欄位的結構化資料,搭配 JSON 與 schema 驗證,下一個 Agent 才能先檢查格式再開始做事
- 共用的狀態放在對話之外,用資料庫或 checkpoint 保存,不要全塞進上下文
- 每個 Agent 只拿到完成自己工作所需的那一小片資料,既省 Token,也縮小出錯的範圍
階層式架構(Hierarchical)
階層式有一個 Manager Agent,也常被稱為 Orchestrator。它接收目標,拆成子任務,分派給底下的 Worker Agents,收回結果再決定下一步。運作方式很接近專案經理帶一組專業工程師。
好處是彈性大,遇到例外可以動態調整,要不要多找一個 Worker、要不要退回重做,都由 Manager 判斷。代價是 Manager 變成單點,判斷錯誤會影響全局,它要讀所有 Worker 的回報,Token 也會越滾越大。常見的緩解方式是讓 Manager 只看摘要與結構化結果,並限制可呼叫的 Worker 清單與重試次數。
管道式架構(Pipeline)
管道式是 A 處理完交給 B,B 處理完交給 C,很接近傳統供應鏈的流水線。每一站職責單一,輸入輸出格式固定,可以單獨測試。
好處是可預測、成本好估、容易監控,哪一站出問題一目瞭然。代價是僵硬,流程之外的例外沒有彈性,前面一站出錯,錯誤會一路往後傳。所以兩站之間通常會放一道驗證關卡,格式不對、欄位缺漏就在關卡擋下來。
兩種架構也常混用。固定的主流程用管道式,其中判斷複雜、路徑不固定的那一站,再交給一個小型的階層式團隊。
| 比較面向 | 階層式 | 管道式 |
|---|---|---|
| 流程控制 | Manager 動態決定 | 事先固定順序 |
| 彈性 | 高,能處理例外 | 低,只走既定路線 |
| 可預測性 | 較低 | 高 |
| Token 成本 | 容易隨 Manager 讀取量上升 | 較好估算 |
| 除錯難度 | 路徑多,較難追 | 逐站追蹤,較容易 |
| 主要風險 | Manager 單點失誤與迴圈 | 錯誤沿管線放大 |
| 適合場景 | 任務內容變化大 | 流程固定、重複性高 |
實作上不必從零開始。目前常見的框架大致分幾類…用圖來定義流程的 LangGraph,狀態與 checkpoint 支援較完整。以角色為中心的 CrewAI,原型做起來很快。各家原生 SDK 也在成熟,OpenAI Agents SDK 用 handoff 交接任務,Google ADK 支援 A2A 通訊協定。Microsoft 把 AutoGen 與 Semantic Kernel 整併成 Microsoft Agent Framework,AutoGen 則進入維護模式。框架更新很快,版本、授權與功能請以官方文件為準。選框架之前,先想清楚職責怎麼切、狀態怎麼存,框架只是實作工具。
用一條資料到報告的流程拆拆看
下面用一條常見的預測分析流程當範例…公開數據進來,模型跑預測,最後交出 PM 看得懂的報告。原本由一個 Agent 從頭做到尾,這裡拆成四個角色,外加一道人工核准。
一句名詞解釋…LightGBM 是一種以決策樹為基礎的梯度提升框架,常用在表格型資料的預測。
| 角色 | 輸入 | 工具與權限 | 輸出 | 檢查點 |
|---|---|---|---|---|
| 資料蒐集 Agent | 資料來源清單與日期範圍 | 只讀的 API 或爬取工具 | 附來源與時間戳記的結構化資料集 | 欄位格式、缺值比例、日期範圍 |
| 預測 Agent | 通過驗證的資料集 | 隔離環境中執行 Python 與 LightGBM | 預測值、評估指標、特徵重要性 | 指標是否合理、是否用時間切分 |
| 報告 Agent | 預測結果與指標 | 無外部工具,只能讀狀態 | 給 PM 的分析報告 | 不得更動任何數字 |
| 稽核 Agent | 報告與原始狀態 | 只讀 | 差異與疑點清單 | 報告內的數字與狀態逐一比對 |
| 人工核准 | 報告與疑點清單 | 由人決定 | 放行或退回 | 對外發送前的最後一關 |
這個拆法有幾個重點。
- 資料蒐集 Agent 只負責拿資料,不做判斷,每筆資料都帶來源與抓取時間,後面出錯才查得到
- 預測 Agent 不讓語言模型心算,改呼叫程式去訓練與預測,模型負責寫程式與解讀,數字一律由程式算出來
- 時間序列資料要用時間切分訓練與驗證,隨機切分會造成資料洩漏,回測成績漂亮得不真實,上線後完全是另一回事
- 報告 Agent 拿到的是已經算好的數字,只負責寫結論、假設、限制與信心程度,數字用模板直接帶入,不讓它重新打字
- 稽核 Agent 拿報告去對原始狀態,抓出報告裡有、狀態裡沒有的數字與說法
- 最後由人決定要不要放行
每個 Agent 的工作範圍夠小,出錯時就知道錯在哪一站。單一 Agent 版本出錯時,只知道最後的報告不對,得整段重讀才找得到原因。[可補上實測…單一 Agent 版本與拆開後各自的 Token 用量,以及定位錯誤所花的時間。]
預測模型只能輔助判斷,市場與外部事件隨時會讓模型失準,報告裡要寫出不確定性,內容不構成投資建議。
落地挑戰…開發 Multi-Agent 架構時的踩坑筆記
下面是這類架構常見的狀況,上線前值得先想好對策。
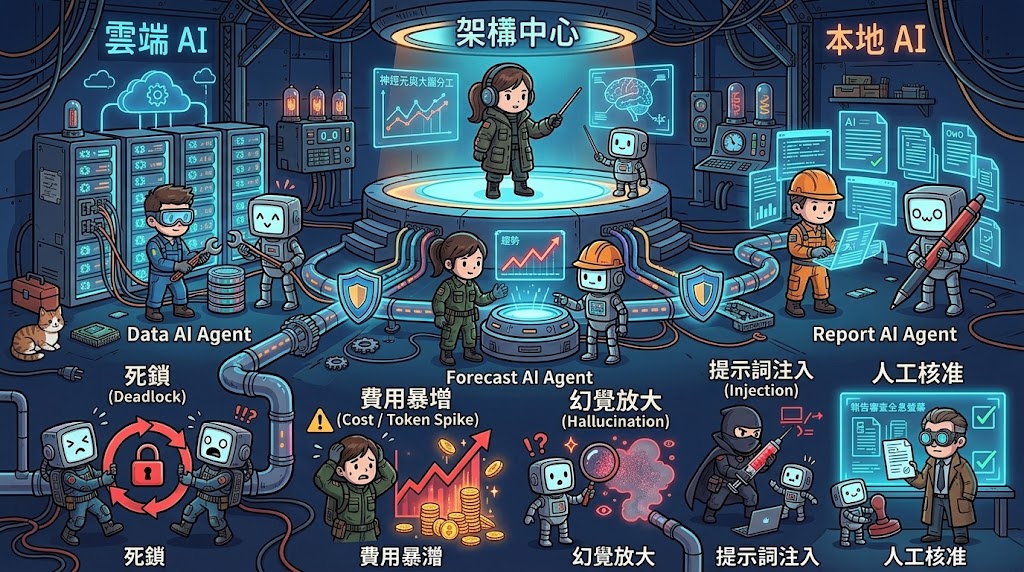
1. 死鎖與無限迴圈
一句名詞解釋…死鎖(Deadlock)是兩個以上的流程各自等對方先動作,結果整體停住不動的狀態。
常見兩種。一種是真的互相等待,A 等 B 的結果,B 在等 A 的確認。另一種是來回修改停不下來,稽核 Agent 說不合格,報告 Agent 改完又被退,反覆下去沒有終點。對策是設定最大回合數,通常三輪以內,超過就升級給人處理。稽核的意見也要具體可執行,只寫「再優化」會讓雙方一直繞圈。
2. API 費用暴增
迴圈會燒錢,每次交接都帶完整歷史也會燒錢,平行跑十個 Worker 更是十倍起跳。對策是每個任務設 Token 預算與步數上限,超過就中止,並記錄每個 Agent 的用量。例行步驟交給較小較便宜的模型,真正需要判斷的才用強模型。用量要有警示,不能等月底帳單才發現。
3. 幻覺沿著流程放大
這是 Multi-Agent 特有的麻煩。上游的 Agent 編了一個數字,下游會把它當成事實繼續加工,最後的報告看起來前後一致,其實整條線都建立在一個捏造的起點上。對策是資料一律帶出處,數字由工具產生而不是由模型輸出,並在每兩站之間驗證格式與範圍。
4. 稽核者與被稽核者同源
用同一個模型當稽核,常有一樣的盲點,一起漏掉同樣的錯。稽核可以換不同模型,或加入規則式檢查,數字比對、單位、日期範圍這類程式能做的就交給程式。AI 產出沒有人替它負責,最終還是要有人把關,核准關卡留在涉及付款、合約、法規與對外發送的地方。
5. 共用狀態被覆寫
平行的 Worker 同時寫同一個欄位,後寫的蓋掉先寫的。狀態要有版本,寫入要能重複執行而不產生副作用,重要節點存 checkpoint,失敗時才能從中間接回去。
6. 看不見每一步在做什麼
沒有紀錄就無法除錯。每一步都要記錄是哪個 Agent、收到什麼輸入、呼叫什麼工具、輸出什麼、花多少 Token。追蹤資料可以用 OpenTelemetry 這類標準格式送進監控系統。
7. Agent之間的訊息也可能被汙染
負責讀網頁與文件的 Agent,可能讀到夾帶惡意指令的內容,也就是提示詞注入,再轉交給有寫入權限的 Agent。Agent 之間傳遞的內容要當成不可信的輸入處理,讀外部資料的 Agent 不配寫入工具,權限依角色最小化。
8. 拆太細
Agent 越多,延遲、成本與交接出錯的機會越多。比較穩的做法是從兩到三個角色開始,出現真實理由才拆,需要不同的工具與權限、指令互相衝突、需要獨立稽核,都算真實理由。
動手的順序,與上線前的對照清單
要動手的話,可以照這個順序…
- 挑一個重複性高、規則明確的流程
- 先切出兩到三個角色
- 定好角色之間傳遞的資料格式
- 在關鍵節點放驗證與人工核准
- 設好 Token 預算與回合上限
- 跑一個月,根據紀錄調整
上線前再對照一次…
- 回合數與步數有上限
- Token 預算與用量警示已經設定
- 數字由工具產生,並帶出處
- 稽核與寫作使用不同模型,或加入規則式檢查
- 狀態有版本與 checkpoint
- 每一步都有完整紀錄
- 讀外部資料的 Agent 沒有寫入權限
- 付款、合約、對外發送有人工核准
每一次出錯都是設計輸入,記進規則,下一輪就少踩一個坑。
回到一開頭那個問題。同一個 AI 檢查自己的作品,抓不到錯,換成另一個角色、另一份指令,甚至另一個模型,才看得出不一樣的東西。人的團隊也是這樣運作,職責清楚、交接有紀錄、關鍵點有人把關。AI Agent 能把人從重複的操作裡拉出來,產出的責任仍在人身上。Multi-Agent 讓分工更細,也讓檢查更必要,分工越細,驗證與核准就越要早早設計進流程。
更多文章…
從命令AI到AI Agent自動化……未來工作流程的重構邏輯
開源LLM教學:用 Ollama + AnythingLLM 打造離線版 NotebookLM(6GB顯卡實測可跑)
開源LLM要在本機跑,要什麼規格
LLM其實還蠻多家推出的,來搞懂LLM,我再想想規劃搜尋工具
為什麼越來越多人提起開源 AI?是趨勢嗎?
AI PC,真的只是多一顆 NPU?
AI 真的需要一直連網嗎?
地端 AI 落地關鍵..別只看 CPU 與 RAM,VRAM 才是 Local LLM 的硬體瓶頸
顯卡對應電源瓦數 線上計算工具
產品活五年,比做到上市難太多