Why Model Capability Defines the Opportunity in the High-End AI Workstation Market
內容目錄
AI工作站的思考
是先選 CPU、記憶體、顯卡和儲存空間,再把不同配置分成低、中、高階。
這套方式容易理解,也方便比較規格。但對真正要買 AI 工作站的人來說,規格表通常沒有回答最重要的問題:這台機器能不能跑我需要的模型?能跑到什麼程度?上下文拉長後會不會卡住?多人使用時,效能還能不能維持?
傳統電腦的分級常以性能差距來呈現。AI 工作站則有一道更明顯的門檻:模型能否載入。當顯存不足以容納模型權重與執行時需要的空間,問題不只是「跑得比較慢」,而可能是模型根本無法在預期條件下運作。
所以,AI工作站的產品分級,可以從「零件等級」轉向「模型能力」。與其只標示中階或高階,不如說清楚一台機器適合跑多大的模型、支援哪些工作負載,以及使用者需要接受哪些條件。
至於產品名稱,「低階」容易讓人聯想到性能不足。如果產品是為個人開發、初期測試或可行性驗證設計,使用「入門級」、「個體開發級」或「基礎驗證級」,通常會比「低階」更準確。名稱不是把規格包裝得更漂亮,而是要讓客戶知道這個級距的用途和邊界。
先理解模型權重如何占用顯存
大型語言模型的參數需要放在記憶體中,才能進行推論。模型權重用 FP16 儲存時,每個參數約需 2 bytes;若模型有 70 億個參數,光權重就大約需要 14GB。
量化會降低每個參數的儲存需求。以概略估算來看,INT8 約需 1 byte/參數,INT4 則約需 0.5 byte/參數。因此,同樣是 7B 模型,FP16 權重約需 14GB,INT8 約需 7GB,INT4 約需 3.5GB。
這只是估算模型權重的基本方式,實際模型檔案通常還會有量化尺度、額外資訊與格式差異,執行時也需要其他空間。常見的 Q4 量化格式,檔案大小不會剛好等於參數量乘上 0.5 byte。量化方式不同,也可能在模型品質、速度與記憶體用量之間做出不同取捨。
| 模型參數量 | FP16 權重大約用量 | INT8 權重大約用量 | INT4 權重大約用量 | Q4 的初步顯存規劃 |
|---|---|---|---|---|
| 7B~8B | 約 14~16GB | 約 7~8GB | 約 3.5~4GB | 約 8~12GB |
| 14B | 約 28GB | 約 14GB | 約 7GB | 約 16~24GB |
| 32B | 約 64GB | 約 32GB | 約 16GB | 約 24~32GB 以上 |
| 70B | 約 140GB | 約 70GB | 約 35GB | 約 48~80GB 以上 |
表中的 Q4 顯存需求是規劃區間,不是對任何模型與軟體組合都成立的保證。模型架構、量化格式、推論框架、上下文長度與同時處理的請求數,都會影響實際需求。尤其是 32B 和 70B 模型,不能只看權重檔案大小,就決定顯卡顯存。
這也是為什麼「32B 模型可以在 24GB 顯存上跑」需要補上條件。若使用合適的量化格式,權重可能放得進去,但長上下文、多使用者或其他程式同時占用顯存時,空間就可能不夠。能啟動模型,不代表所有工作情境都能穩定運作。
權重以外,還要替上下文留空間
模型載入後,顯存需求不會停止增加。推論過程中的 KV Cache 會隨著上下文長度和生成內容增加而占用空間。同一個模型,短對話可能跑得動,換成長文件分析或長時間對話,就可能出現速度下降、需要把部分資料移到系統記憶體,甚至因為 OOM 而中止。
所以,產品規格若只寫「支援 32B」,資訊仍然不足。最好同步說明使用的量化格式、測試時的上下文長度、建議的工作負載,以及測試時有沒有其他程式占用顯存。
規劃時也要留出緩衝,而不是把顯存用到剛剛好。緩衝空間不是固定比例就能涵蓋所有情況,應依模型和實際場景驗證。若客戶會使用長上下文、同時處理多個請求,或需要保留其他 GPU 工作,就要納入更高的顯存需求。
產品線以工作能力來分級
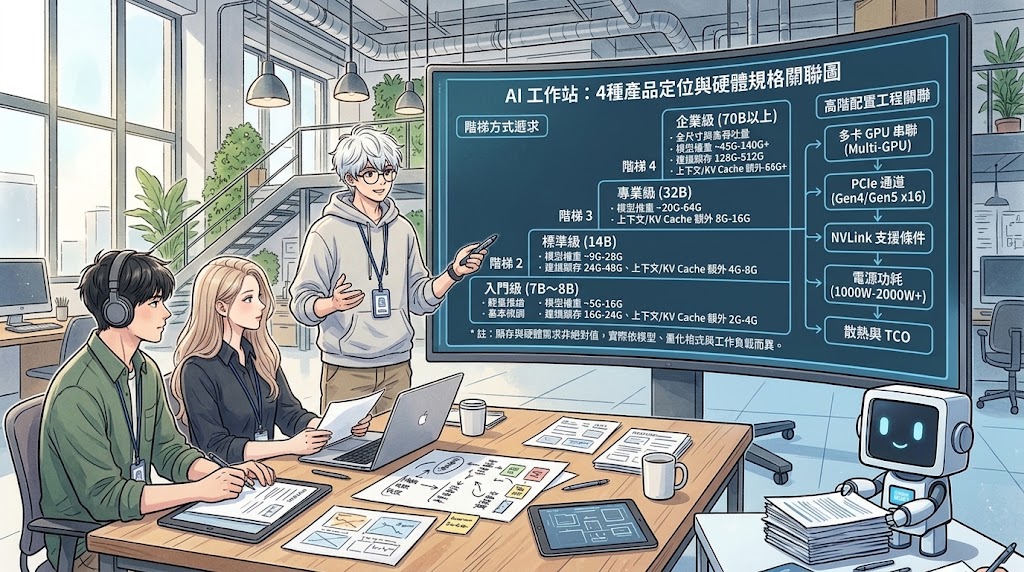
了解模型與顯存的關係後,產品線就能從「低、中、高」轉成不同的能力定位。這些名稱不代表固定的硬體規格,而是幫助客戶先確認自己的工作需求,再決定配置。
| 產品定位 | 主要模型能力 | 配置規劃方向 | 適合的工作情境 |
|---|---|---|---|
| 入門級/基礎驗證級 | 7B~8B | 以單卡為主,依量化格式與上下文需求規劃顯存 | 個人測試、開發驗證、基礎文件處理 |
| 標準級/輕量應用級 | 14B | 單卡顯存以 16~24GB 作為初步評估範圍 | 文件摘要、資料擷取、部門內部應用 |
| 專業級/深度推理級 | 32B | 評估高顯存單卡或多卡方案,確認上下文與速度要求 | 複雜資料分析、程式協作、內部知識應用 |
| 企業級/私有部署級 | 70B 以上或多使用者服務 | 規劃 GPU 顯存、互連、電力、散熱與系統維運 | 私有化部署、研究工作負載、部門級服務 |
這樣的分級方式,能讓業務先從使用情境開始談,而不是讓客戶自己讀一整頁零件規格。客戶想做文件整理,與需要在內部部署大型模型,可能根本不需要同一種配置。
詢問「想跑多大的模型」是個好的開場,但後續還得問清楚模型要處理什麼資料、一次要讀多少內容、回應速度有沒有要求、會不會多人共用,以及資料是否能送到外部服務。這些答案會直接影響硬體選擇,也能避免只靠模型參數量推產品。
高階市場的價值,來自跨過能力門檻

高階 AI 工作站市場的機會,不只在於裝上更多顯卡或提供更大的顯存,而是部分企業的工作需求,確實無法只靠入門級設備滿足。
小型模型足以處理部分摘要、分類與初步整理工作;當任務涉及較長的資料脈絡、複雜的推理要求或更高的回答品質,企業可能會評估更大的模型。但模型規模不是能力的唯一指標。模型訓練品質、微調方式、提示設計與檢索流程,都會影響最後的表現。較大的模型不一定在每個特定任務上都比較適合,也不代表模型參數一增加,能力就會按比例提升。
因此,高階產品的價值不宜只建立在「能跑 70B」這個數字上。更重要的是能不能在指定的量化格式、上下文長度與使用負載下,穩定完成客戶真正要做的工作。
對某些企業來說,地端部署能提供資料管理與內部控制上的選擇,也可能降低對外部服務的依賴。不過,這不代表每家公司都需要地端大模型。有些團隊的使用頻率低,雲端服務的彈性可能更適合;有些團隊則有長期、高頻率或特定資料管理需求,才值得評估自建設備。
高階市場的商業機會,因而不只是顯卡的售價,而是能否提供一套經過驗證、可維護、符合使用情境的系統。客戶買的不是一個抽象的「AI 能力」,而是可以放進既有工作流程、並且能持續運作的解決方案。
多卡配置,顯存加總不等於效能保證
當單張顯卡的顯存不足時,多卡是可能的選項,但多張卡的顯存不會自動變成一塊可自由使用的大記憶體。推論框架必須支援模型切分,系統也要能讓 GPU 之間傳遞所需資料。
GPU 間的傳輸方式會影響多卡推論效率。PCIe 是多數系統中的主要通道,但實際可用頻寬會受到處理器、主機板、插槽配置與 PCIe 通道數影響。即使插槽外觀看起來有多個,實際上也不一定都以相同頻寬運作。Peer-to-Peer 傳輸是否可用,則要看 GPU、平台、驅動程式與軟體組合。
NVLink 也不是所有顯卡都支援的通用方案,必須確認特定 GPU 和平台具備相關功能。即使硬體具備高速互連,推論軟體是否能有效利用,也會影響結果。採購多卡系統前,應針對預計使用的模型和軟體進行實測,確認模型能否分配到多張卡上、生成速度是否符合需求,以及系統在長時間負載下是否穩定。
多卡也會讓電力和散熱規劃變得複雜。高功耗 GPU 長時間運作時,熱量會集中在機殼內,顯卡間距、進出風路徑、電源供應能力與供電品質都需要一起檢查。散熱不足可能導致顯卡降頻;電力規劃不當,也可能造成不穩定或無法支援預期的負載。
因此,從 32B 升級到 70B,通常不是單純把顯卡換大或多插一張卡。產品開發需要把 GPU、主機板、處理器平台、機殼、電源、散熱與軟體環境視為一整套系統驗證。
把 TCO 納入產品設計
企業評估高階 AI 工作站時,也需要看總持有成本,也就是 TCO。硬體採購只是第一筆支出,後面還有電費、散熱、維護、設備折舊與人力成本。
若設備長時間滿載,電費與散熱需求可能比偶爾使用時高出許多;若系統需要專人維護或有較高的故障影響,這些也應計入成本。相對地,雲端服務則可能依使用量產生持續費用,並涉及資料管理與外部服務依賴。兩者的成本比較,需要根據實際使用頻率、工作負載、設備壽命與維運條件計算,不能直接宣稱地端設備一定會在某個時間內回本。
「剛好夠用」不是把規格壓到最低,而是讓配置對得上工作需求,同時保留合理的擴充與緩衝空間。盲目追求最大配置,可能讓企業承擔沒有必要的電力與維護成本;配置得太緊,則可能很快遇到顯存不足或效能瓶頸。
模型與推論工具仍在變化,今天適用的配置,未來可能因模型、量化方法或軟體更新而改變。產品規劃不必把某個模型名稱或規格寫成唯一答案,而應說清楚測試方法、支援條件、升級方式與限制。客戶需要知道的,是這套系統目前能做什麼,以及需求改變時有哪些調整空間。
當 AI 工作站從零件清單變成能力方案,產品分級才真正與使用者的工作連上。模型大小提供了一個容易理解的起點,但顯存、上下文、多卡互連、散熱、軟體支援和 TCO,才共同決定這項能力能否穩定落地。高階市場的價值,也在這些條件都被處理好的時候,才會真正顯現。
更多文章…
AI Agent產品化路線Roadmap如何規劃?從 PoC到商業落地的 PM 技術思考
從命令AI到AI Agent自動化……未來工作流程的重構邏輯
開源LLM教學:用 Ollama + AnythingLLM 打造離線版 NotebookLM(6GB顯卡實測可跑)
開源LLM要在本機跑,要什麼規格
LLM其實還蠻多家推出的,來搞懂LLM,我再想想規劃搜尋工具
為什麼越來越多人提起開源 AI?是趨勢嗎?
AI PC,真的只是多一顆 NPU?
AI 真的需要一直連網嗎?
地端 AI 落地關鍵..別只看 CPU 與 RAM,VRAM 才是 Local LLM 的硬體瓶頸