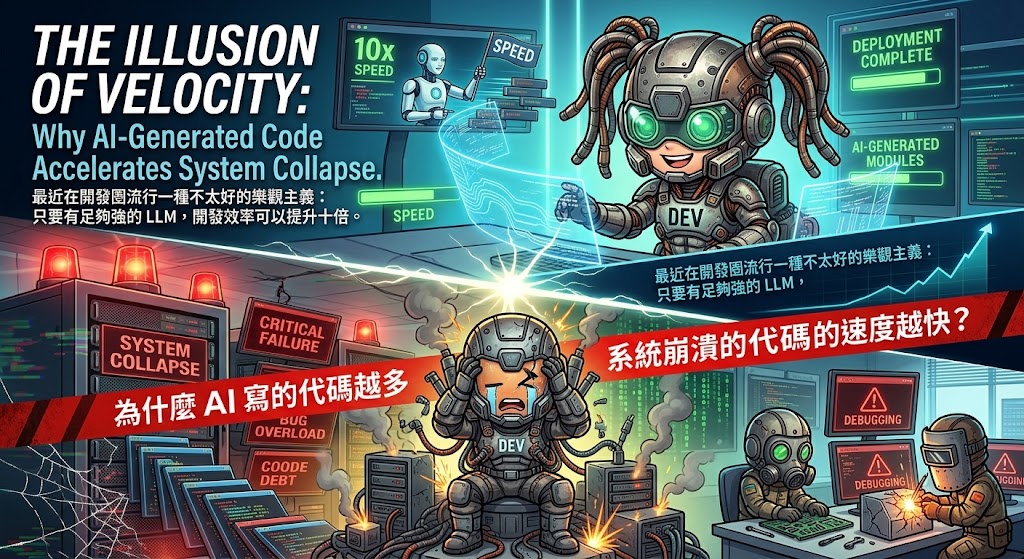
The Illusion of Velocity: Why AI-Generated Code Accelerates System Collapse
內容目錄
最近在開發圈流行一種不太好的樂觀主義:只要有足夠強的 LLM,開發效率可以提升十倍。
AI寫程式已是很多團隊開始追求一種「產出量」的快感。以前需要三天才能寫完的一個功能模組,現在只要對 Prompt 進行幾次微調,AI 就能在三十秒內吐出數百行看起來非常專業、格式工整且完全能運行的代碼。
對於很多管理層或初級開發者來說,這簡直是奇蹟。他們看到的是進度條飛快地推進,功能一個接一個地被「完成」。
但作為一個重視系統思考與長期價值的開發者,看到的不是效率的提升,而是一場巨大的「技術債風暴」正在悄悄成形。
當 AI 產出的代碼量呈指數級增長時,系統崩潰的速度也會同步加快。這不是因為 AI 寫錯了,而是因為它寫出了太多「看起來正確但缺乏系統架構」的代碼。
AI寫程式「看起來正確」是最高級的陷阱
我們必須先定義一個核心問題…什麼是「正確的代碼」?
對 AI 來說,正確是指「能通過編譯」且「能實現當下的功能需求」。如果你要求它寫一個登入功能,它會給你一套標準的流程:驗證輸入 → 查詢數據庫 → 返回 Token。這段代碼跑起來完全沒問題,而且寫得比很多人都漂亮。
但真正的系統開發,核心不在於「實現功能」,而在於「維護一致性」。
一個健康的系統需要統一的錯誤處理機制、一致的數據流向、以及對邊界條件的周全考量。然而,AI 產出的代碼是「碎片化」的。它在寫當下的這個函數時,並不真正關心這個函數如何影響到五個模組之外的另一個邏輯。
它給你的是一個個精美的「零件」,而不是一個完整的「機器」。
當你把數千行 AI 產出的碎片代碼拼湊在一起時,系統會進入一種極其脆弱的狀態。每個零件單獨看都沒問題,但它們之間的接縫處充滿了隱形的裂縫。一旦壓力增加或需求變動,這些裂縫會迅速擴散,導致系統在一個完全不可預見的地方突然崩潰。
AI 代碼的「熵增」過程:從乾淨到混亂

為了讓大家理解為什麼崩潰速度會加快,我們得看看 AI 代碼在系統中如何演化。這是一個典型的「熵增」過程。
第一階段:蜜月期(The Honeymoon Phase)
在項目的初期,AI 寫的代碼非常高效。因為系統規模小,沒有複雜的依賴關係。你感覺到速度提升了 5 倍,功能快速堆疊,所有的單元測試(Unit Test)都通過了。
第二階段:碎片化期(The Fragmentation Phase)
隨著功能增加,你開始要求 AI 在既有代碼上增加新功能。AI 為了快速達成目標,會採取最簡單的「補丁式」寫法。它不會花時間去思考如何重構現有的類別(Class)以適應新需求,而是直接在函數裡加上 if-else 判斷。
這時候,代碼開始出現「重複性」。同樣的邏輯在三個不同的模組中被 AI 以三種略微不同的方式實現了。
第三階段:不可見的耦合(Invisible Coupling)
當系統規模達到一定程度,AI 開始在不同的模組間建立依賴。但因為 AI 缺乏全局視角,它建立的依賴是隨機且混亂的。你修改了模組 A 的一個參數,結果導致模組 Z 的一個冷門功能崩潰。
這時,開發者開始恐慌。因為代碼量太大了,沒有人能完全掌控所有的邏輯路徑。
第四階段:崩潰臨界點(The Collapse Point)
最終,系統進入一種「觸之即碎」的狀態。每修復一個 Bug,就會產生兩個新的 Bug。開發者發現,雖然 AI 能幫他快速寫出修復方案,但這些方案只是在舊的爛攤子上蓋新房子。
最終,系統在一次微小的版本更新中徹底崩潰。這不是因為某一行代碼寫錯了,而是因為系統的整體複雜度已經超過了人類大腦能維護的極限。
技術債的指數爆炸:從「快」到「死」
在傳統開發中,技術債(Technical Debt)的累積通常是有跡可循的。開發者因為趕進度而選擇權宜之計,心中很清楚這裡寫得爛,未來需要重構。
但 AI 引入了一種新型態的技術債:「無意識的債務」。
因為 AI 寫代碼的速度太快,開發者在審核(Review)時會產生一種錯覺——「反正它跑得起來,而且邏輯看起來沒問題,先過了吧」。
當你用 AI 快速堆疊功能時,你其實是在用「速度」換取「複雜度」。
想像一下,原本一個功能需要 100 行精心設計的代碼,但 AI 用 300 行代碼實現了同樣的功能(因為它不擅長抽象化,傾向於寫重複的邏輯)。當你的系統有 100 個功能時,你原本應該維護 10,000 行代碼,現在卻得面對 30,000 行。
這導致了維護成本的爆炸。當你需要修改一個基礎邏輯時,你發現這個邏輯在 50 個不同的 AI 片段中被重複實現了 50 次。你修改了 48 個,漏掉了 2 個,然後系統在半夜三點崩潰。
這就是 AI 增加開發效率的迷思:它縮短了「從 0 到 1」的時間,卻極大地延長了「從 1 到 100」的痛苦。
開發者心理的「快感陷阱」
為什麼我們明知有風險,卻還是停不下來?這涉及到一種心理上的「快感陷阱」。
寫代碼本質上是一種極其痛苦的思考過程。你得在腦中構建模型,處理邊界條件,忍受數小時的邏輯死胡同。
而 AI 把這個過程變成了「抽卡遊戲」。你輸入 Prompt → 看到代碼 → 運行成功 → 獲得成就感。
這種即時反饋(Instant Gratification)會讓開發者的大腦分泌多巴胺。我們會漸漸習慣於「不需要思考就能看到結果」的快感。久而久之,我們失去了對代碼品質的敏感度。
我們不再問「這是不是最優的架構?」,而是在問「AI 這次能一次跑通嗎?」。
當一個團隊的文化變成「追求 AI 的跑通率」而非「追求系統的穩健性」時,這個團隊就已經在走向崩潰的路上了。開發者從「創造者」變成了「AI 代碼的搬運工」,他們失去了對系統的深度掌控。
系統思考的缺失:AI 不懂什麼叫「架構」
為什麼 AI 沒辦法解決這個問題?因為 AI 缺乏「全局視角」。
真正的架構設計(Architecture)是一種關於「捨棄」的藝術。一個好的架構師會思考:為了讓系統在三年後依然可擴展,我現在應該放棄哪些便捷的寫法?我應該如何定義模組之間的邊界,以確保變動不會引起連鎖反應?
AI 沒辦法做這種思考。它永遠在追求「當下的最優解」。
它會給你最流行、最便捷的寫法,但它不懂得你的業務邏輯在半年後可能會如何演進。它不能告訴你:「雖然這樣寫很快,但這會破壞我們整體的數據一致性。」
當開發者過度依賴 AI,他們實際上是在交出系統的「控制權」。當代碼量增加到一定程度,沒有一個人能真正理解整個系統是如何運作的。系統變成了一個黑盒子。
這時,系統的崩潰不再是 Bug,而是一種必然。因為系統已經複雜到超過了人類大腦能維護的邏輯上限,而 AI 又無法承擔維護的責任。
真正的效率:慢下來,才能快起來
如果你想在 AI 時代保持競爭力,你必須意識到:代碼的數量 ≠ 產品的進度。
真正的高效率,不在於你一天能讓 AI 產出多少行代碼,而是在於你能用最少的代碼,實現最穩定的邏輯。
我建議所有開發者採取以下策略:
1. 嚴格限制 AI 的產出範圍: 不要讓 AI 決定架構,只讓它負責實現微小的、獨立的單元函數。
2. 將審核時間翻倍: 審核 AI 代碼的時間應該比審核人類代碼更長。你要尋找的不是 Bug,而是「不一致性」。
3. 強制執行重構(Refactoring): 每當 AI 幫你快速完成一個功能後,立刻花時間將其「人類化」——刪除重複邏輯,將其抽象化,確保它符合整體的系統架構。
不要成為 AI 的搬運工
AI 是一個強大的槓桿,但槓桿的另一端必須是堅實的基礎。
如果你的基礎是混亂的,AI 只會幫你把混亂放大。它能讓你在第一週感覺像個天才,讓你在第二週感覺像個神,然後在第三週讓你面對一個無法修復的崩潰系統,陷入深深的絕望。
不要被「開發效率提升十倍」的口號欺騙。真正的效率,是建立在對系統的深度掌控之上。
記住,代碼是負債,只有能帶來價值的運行功能才是資產。在追求產出速度之前,請先問自己:我現在增加的這行代碼,是在幫我蓋大樓,還是在為未來的崩潰埋下地雷?
更多文章


