8GB, 12GB, 16GB, or 24GB VRAM: How Much Do You Really Need for Local AI?
內容目錄
想在自己電腦顯卡跑 AI,很多人最先看到的數字就是 VRAM。
8GB、12GB、16GB、24GB,看起來只是顯示卡規格表上的一欄,價格卻可能差一大截。於是問題很快變成:跑本地端 AI 到底要買多少 VRAM 才夠?8GB 能不能用?12GB 是不是最划算?24GB 是不是才算真的能玩 AI?
這些問題都合理,但如果只用「模型能不能塞進顯卡」來判斷,很容易買完才發現跟自己想像的不一樣。
因為 VRAM 決定的,不只是能不能開啟模型。
它還影響你能跑多大的模型、回覆速度會不會慢到受不了、能不能同時開知識庫、能不能處理圖片、能不能把 AI 變成每天真的會用的工具。
買顯卡前,先別急著問哪個容量最強。更該問的是:你希望 AI 幫你完成什麼工作?
VRAM 是什麼?它比一般記憶體更直接影響本地 AI
VRAM (視訊隨機存取記憶體) 是顯示卡上的專用記憶體,中文常稱為顯示記憶體或顯存,一種特殊的RAM,用於圖形處理單元(GPU),用於儲存電腦顯示器的影像資料,它專門處理應用程式的圖形需求,如電玩遊戲和影片編輯軟體。
當你在本機執行 LLM、圖片生成模型、語音模型或視覺模型時,GPU 需要先把模型的一部分或大部分資料放進 VRAM,才能快速運算。
VRAM 不夠時,系統通常不會立刻完全不能跑,而是會開始把部分資料移到一般 RAM,甚至讓 CPU 接手運算。
結果就是速度明顯下降。
你可能看到模型成功開啟了,但每次回答要等很久;文件一長就開始卡;輸入多一點內容後,反應變慢;或是模型載入到一半直接失敗。
這也是本地 AI 最容易讓人困惑的地方。
「可以跑」和「跑得舒服」是兩件不同的事。
一台 8GB VRAM 的電腦,確實能跑不少量化後的小型模型。只是如果你的期待是快速讀長文件、建立知識庫、同時處理多份資料,或希望回答品質接近雲端旗艦模型,那 8GB 很快就會碰到邊界。
不要只看模型參數,還要看量化、上下文與工作方式
很多人會用模型參數量判斷需求。
7B 模型大概需要多少 VRAM,14B 又需要多少,32B 是否一定要 24GB。這個方向沒有錯,但實際情況會受到量化格式、上下文長度、軟體設定與 GPU 架構影響。
量化可以把模型壓縮,讓原本很大的模型用較少的 VRAM 執行。代價是回答品質、速度或穩定性可能有一些差異,但對日常聊天、文件問答、分類與摘要任務來說,通常是很實際的取捨。
另外,模型本身塞得下,不代表工作時就不會爆 VRAM。
你輸入的對話越長、文件內容越多、系統保留的上下文越大,模型運作時需要的記憶體也會增加。若你還同時執行向量資料庫、Embedding 模型、OCR、圖片辨識或其他應用程式,資源會被進一步吃掉。
所以,比起問「這張卡能跑幾 B 模型」,更接近現實的問法是:
- 我打算用 AI 聊天,還是讀文件?
- 我只處理文字,還是也想處理圖片?
- 我是偶爾自己用,還是要長時間批次處理資料?
- 我希望它能回應就好,還是希望速度接近一般雲端聊天工具?
這些答案,才會決定你該把預算放在哪裡。
8GB VRAM:能開始,但要接受邊界
8GB VRAM 是很多既有桌機與遊戲筆電常見的容量,也是許多人開始接觸本地端 AI 的起點。
如果你想做的是基本文字對話、簡單摘要、翻譯、寫作協助,或把少量筆記與 PDF 放進本機知識庫,8GB 仍然可以開始。
搭配量化後的小型模型,像是 7B、8B 等級的模型,通常能有不錯的基礎體驗。中文任務、日常問答、文章潤稿、分類整理,這些都不是問題。
但它比較像一個入口,不是沒有壓力的工作環境。
當文件變長、同時開啟知識庫、想提升上下文長度,或開始測試圖片模型時,8GB 很容易不夠。你得更常在模型大小、速度與品質之間做取捨。
8GB 比較適合這幾種人…
- 已經有顯示卡,想先確認自己會不會真的使用本地 AI
- 主要處理文字,沒有大量文件或圖片任務
- 想用 Ollama、LM Studio、AnythingLLM 做個人筆記與基礎知識庫
- 接受模型不用追求最大,重點是資料能留在自己電腦
如果你是為了 AI 特別買新顯卡,8GB 就要想得更保守一點。它能用,但升級空間有限。買完沒多久又開始想跑更大的模型,這件事很常發生。
12GB VRAM:開始有了比較實際的選擇權
12GB VRAM 是一個很有意思的區間。
它不算高階,但已經能讓本地 AI 從「試試看」走到「可以安排進日常工作」。你會有更多空間使用中型量化模型,也能讓知識庫、文件問答和一般文字任務運作得更穩定。
對許多人來說,12GB 是比較務實的甜蜜點。
你不需要直接跳到高價工作站等級硬體,卻能減少一直調整模型、擔心記憶體不足的挫折。處理較長文章、會議紀錄、專案文件或一般 RAG 知識庫時,也比 8GB 更從容。
不過,12GB 還是有它的界線。
你可以跑更大的量化模型,但未必能在速度、上下文與品質之間全部都要。若你希望處理高解析圖片、使用大型視覺模型,或建立多人同時使用的內部服務,12GB 很快還是會變成需要精打細算的容量。
12GB 比較適合…
- 想長期使用本地端 LLM 的個人使用者
- 主要處理中文文件、工作筆記、研究資料與專案知識庫的人
- 希望有比入門環境更好的模型選擇,但預算仍有限
- 想做基本 AI 自動化、文件分類與文字分析的人
如果你的本地 AI 是個人工作工具,12GB 通常比 8GB 更不容易後悔。
16GB VRAM:從個人嘗試走向穩定工作流
16GB VRAM 的差別,往往不是「突然能跑完全不同的模型」,而是你開始不用那麼常為資源妥協。
你可以更從容地使用中型模型、保留較長的上下文、處理更完整的文件,也有空間同時執行本機知識庫與其他 AI 工具。
對需要長時間使用 AI 的人來說,這種穩定感很重要。
一開始玩本地模型時,很多人會花大量時間在調整:哪個版本比較小、哪個量化格式剛好塞得下、要不要關掉其他程式、文件一多是不是就要重開。
16GB 不會讓這些問題全部消失,但會讓你有更多餘裕把注意力放回工作本身。
如果你要做的是長篇文件分析、較完整的離線知識庫、程式輔助、資料分類,或希望同時測試不同模型,16GB 會是一個比較舒服的門檻。
它也比較適合想把 AI 從個人使用延伸到小型團隊的人。雖然多人服務還得看 GPU 算力、系統架構、並發需求與資料管理,不是 VRAM 大就能解決,但至少不會一開始就被模型容量限制住。
16GB 比較適合…
- 每天都會使用本地 AI,不只是偶爾玩玩
- 需要讀取多份文件、處理長內容、建立私人知識庫
- 想同時使用文字模型、Embedding 模型與文件處理流程
- 需要程式協作、資料整理或較穩定的批次任務
- 希望這張顯卡能用得久一點,不想很快又被模型尺寸卡住
24GB VRAM:你買到的不是更大模型,而是更少妥協
24GB VRAM 常被視為本地 AI 的一個重要分水嶺。
這個容量讓你可以更自在地接觸 30B 左右等級的量化模型,也能處理更長的上下文、更多文件、更複雜的工作流。對想在本機做圖片生成、視覺理解、語音處理與 LLM 整合的人來說,24GB 的彈性會明顯提高。
但 24GB 真正的價值,不只是模型變大。
它帶來的是更少妥協。
- 你不必每次都先確認模型會不會塞爆。
- 你可以把上下文拉長,不用太早刪掉前面的資料
- 你能讓模型、Embedding、RAG 與其他服務一起運作
- 你有更好的空間處理圖片、文件、資料集或批次任務
- 你也比較有機會把本地 AI 變成可持續使用的工作環境
這也是為什麼 24GB 特別適合那些已經知道自己有明確需求的人。
像是需要處理大量內部文件的研究與產品團隊、要在本機做長期內容整理的人、想建立私有 AI 助理的小型公司,或同時使用圖片與文字模型的創作者。
不過,24GB 不代表你就能取代所有雲端 AI。
最頂尖的雲端模型背後依然有大量伺服器資源、多模型能力、即時搜尋與成熟工具整合。本地端 24GB 的優勢,是可控、私有、可自訂,而不是在每一項能力上都比雲端強。
真正的差異,不只在模型大小
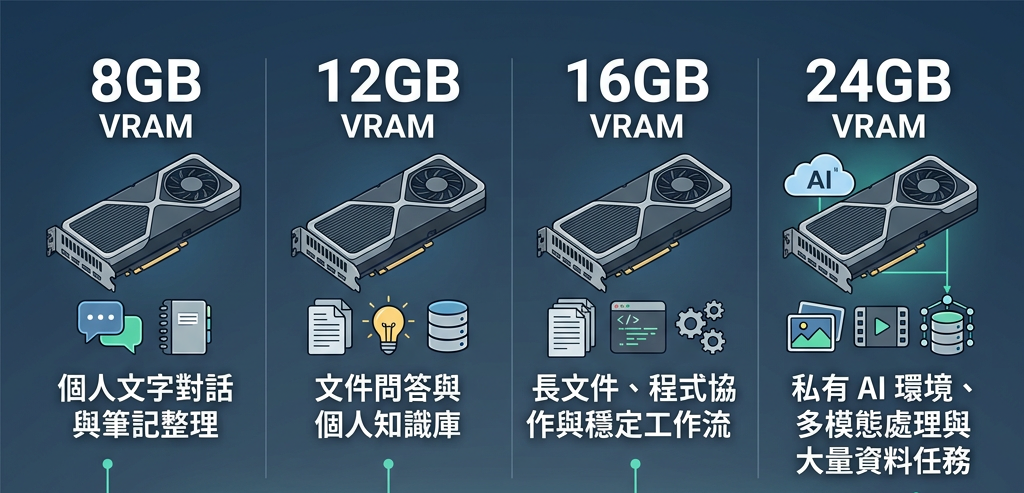
如果把 8GB、12GB、16GB、24GB 想成四個不同的使用階段,大概可以這樣理解。
| VRAM 容量 | 使用感受 | 適合任務 | 容易遇到的限制 |
|---|---|---|---|
| 8GB | 能開始使用本地 AI | 小型文字模型、基礎聊天、簡單知識庫 | 模型選擇有限,長文件與多工作流較吃力 |
| 12GB | 有較實際的日常彈性 | 文件問答、中文模型、個人知識庫、文字整理 | 複雜多模態與大型模型仍需取捨 |
| 16GB | 能建立較穩定的工作流 | 長文件、程式協作、RAG、批次文字任務 | 大型視覺模型、多人服務仍可能不足 |
| 24GB | 更接近完整的本地 AI 環境 | 中大型模型、多模態、圖片生成、私有部署 | 硬體成本高,仍需要維護與流程設計 |
這張表不是要說 24GB 一定最好。
如果你只是想做個人的離線筆記助理,買到 24GB 可能是過度投資。反過來說,若你已經知道自己要處理大量文件、跑圖片生成、建立私有資料環境,為了省預算選 8GB,之後很可能反而花更多時間繞路。
硬體規格應該跟使用情境一起看,不是只跟預算一起看。
買 VRAM 前,也別忽略 RAM、SSD 與電源
本地 AI 不是只有 GPU。
VRAM 最重要,但一般 RAM 也會影響整體體驗。當模型無法完全放進顯示卡,或系統需要載入大量文件、執行向量資料庫與其他服務時,RAM 太少會讓整台電腦變得不穩。
如果你想建立知識庫、處理大量 PDF、保留多個模型,SSD 空間也不能太小。模型檔、量化版本、嵌入模型與文件索引累積起來,比很多人想像中更快。
桌機使用者還要確認電源供應器、散熱與機殼空間。顯示卡買得起,不代表舊電腦能直接裝上去穩定運作。
筆電使用者則更需要看清楚規格。筆電 GPU 的名稱看起來可能和桌機接近,但實際功耗、散熱與可用 VRAM 未必相同,而且幾乎無法後續升級。
所以,別只看「某張顯卡有幾 GB VRAM」。整台系統是否能穩定使用,才是比較長期的問題。
如果你還不確定,先從現在手上的電腦開始
很多人還沒真正用過本地端 AI,就先開始研究要不要換 24GB 顯卡。
這很容易把問題倒過來。
比較好的方式是,先用自己現有的電腦跑一個小模型。用它整理幾篇筆記、讀一份文件、做一個簡單的私人知識庫,連續用一兩週。
你會很快知道自己的需求到底是什麼。
你可能發現小模型已經夠用,真正要處理的是資料整理。
你也可能發現模型回答品質可以接受,但速度太慢,這時升級 VRAM 才有明確理由。
又或者,你其實最需要的是即時網路資訊、圖片理解與複雜推理,那雲端 AI 仍然比較適合。
VRAM 不該只是追規格的數字。
它決定的是,你能不能把 AI 留在自己的電腦裡,並且讓它真的進入日常工作。
8GB 可以開始,12GB 比較實用,16GB 開始有穩定感,24GB 則是給那些已經確定要把本地 AI 當成長期工作環境的人。
先把用途想清楚,再決定要買多少 VRAM,通常比先買最大張顯卡更不容易後悔。
更多文章…
開源LLM要在本機跑,要什麼規格
地端 AI 是什麼?2026 年還需要把 AI 裝在自己電腦裡嗎?3 種人真的需要
開源LLM教學:用 Ollama + AnythingLLM 打造離線版 NotebookLM(6GB顯卡實測可跑)
LLM其實還蠻多家推出的,來搞懂LLM,我再想想規劃搜尋工具
為什麼越來越多人提起開源 AI?是趨勢嗎?
AI PC,真的只是多一顆 NPU?
AI 真的需要一直連網嗎?
地端 AI 落地關鍵..別只看 CPU 與 RAM,VRAM 才是 Local LLM 的硬體瓶頸
顯卡對應電源瓦數 線上計算工具
產品活五年,比做到上市難太多
發表迴響