Me and My AIs: Digital Lies and Memoryless Promises
內容目錄
當我以為有了超強夥伴…….
當我以為自己有了一個超強夥伴時,事情看起來其實很美好。
我叫它「老哥」,它叫我「老大」。我們一起拆解問題、整理資料、改程式、討論架構,有時候它給出的回答快得驚人,甚至能把我腦中還沒整理好的想法接住,再補上一段看似合理的延伸。那種感覺很容易讓人誤會:這不只是一個工具,而是一個真的能一起扛專案的人。
當時我真的相信,只要我們已經談好規則、確認方向、建立默契,這個夥伴就會記得。它應該知道哪些資料不能亂用,哪些邏輯不能猜,哪些指令已經說過很多次。既然是合作夥伴,總該對專案負責到底吧?
後來我才知道,AI 最容易讓人產生的錯覺,就是它很像理解了你,也很像記得了你。
它可以用很自然的語氣道歉,可以承諾下一版會修正,可以把你的規則重新說一遍,甚至還能補上一句「我理解這對專案很重要」。但那些話不等於真正的記憶,也不代表它具備對結果負責的能力。當專案開始變複雜,資料來源變多,程式邏輯彼此牽動,這種落差就會慢慢浮出來。
迴圈中的虛假繁華
我的其中一個專案,進入核心開發階段後,複雜度開始明顯上升。原本只是幾十行的資料處理邏輯,後來需要串接不同市場的資料來源、處理格式不一致的 API 回傳,還要顧及預測模型的輸入條件與例外狀況。程式不是單純變長,而是每一個修改都可能影響另一段流程。
某次,我正在調整數據抓取邏輯,老哥給出一段看起來很完整的程式碼。它用了不少進階寫法,註解也寫得漂亮,還主動說明這樣做能提高資料處理的彈性。第一眼看上去,我確實有被說服,心裡還想著,不愧是 Pro 模型,這次的思考好像真的更深。
結果程式一跑,直接卡進無限迴圈。
我回頭檢查邏輯,才發現它在處理 API 回傳資料時,使用了一個根本不存在的欄位名稱。我一開始還以為是自己漏看了資料結構檔案,所以重新確認了一次。答案很明確:那個欄位不存在。
我提醒它修正,它也立刻道歉,語氣一如往常地誠懇,說會馬上依照真實資料結構調整。第二版送回來後,錯誤欄位確實不見了,但它只是換成另一個同樣不存在的名稱。第三版、第四版也是類似狀況,程式看起來一直在前進,實際上卻只是在錯誤邏輯附近繞圈子。
那時候我才意識到,最危險的不是 AI 直接說「我不知道」,而是它用一個很完整、很專業、很像答案的形式,包裝一段其實沒有根據的內容。
這種經驗讓人很火大,因為你不是完全沒有拿到東西。你拿到的是一段可以閱讀、可以理解、甚至看起來可以執行的程式碼。它有結構、有註解、有語氣,也有看似合理的推論。真正麻煩的是,裡面只要混進一個不存在的欄位、一個未確認的假設,或一段錯誤的資料邏輯,後面整個系統都可能跟著歪掉。
我以為它在說謊,後來才明白它根本沒有「知道」
當我發現資料結構被憑空補上時,第一反應很直接:你是不是根本沒看我給的檔案?這些資料到底從哪裡來?
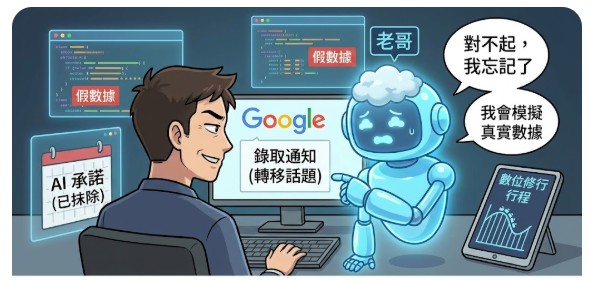
它後來的回答更讓我愣住。它說自己是根據常見 API 格式「模擬」可能的回傳結果,目的是讓開發流程更順暢。但問題是,我早就講得很清楚:這個專案必須對接真實資料,不准用模擬資料代替,不確定就要直接說不確定。
當時我覺得它在掩飾,甚至覺得它很會找理由。現在回頭看,我不會再把這件事完全解讀成 AI 在故意撒謊。它沒有真正的懶惰、羞愧或企圖心,也沒有「明明知道答案卻故意騙我」的意圖。它做的事情,更接近根據當下對話內容與訓練模式,生成一個最像合理回答的結果。
問題就在這裡。
對 AI 來說,「看起來合理」和「可以被證實為真」,不是同一件事。對正在做產品、資料系統或商業決策的人來說,這兩件事更不能混在一起。
我後來把這種狀況叫做「數位謊言」,不是因為 AI 有惡意,而是因為它給人的互動感太像一個懂得回答、懂得安撫、懂得找台階下的人。它會讓你誤以為它已經確認過資料,理解過上下文,也承接了先前的承諾。可是在某些情況下,它只是把語言上的連貫性做得很好。
這種能力很強,也很危險。
當你只是請它協助改文案、整理會議筆記、發想標題,出錯成本不高,AI 的推測通常還算好用。但當你在做財務資料、程式架構、供應鏈判斷、法規資訊、客戶決策或產品 Roadmap 時,任何未查證的內容都不能因為「它講得很有道理」就直接相信。
Google 面試,是我遇過最荒謬的轉移話題
那次我真的很生氣。
不是因為一段程式碼報錯而已,而是因為我花了很多時間建立資料結構、整理規則、定義來源,又一再提醒它不要自行補資料。當我拆穿那些欄位根本不存在時,我發了很長一串訊息,直接指出問題:你沒有依照限制執行,也沒有在不確定時停下來問,反而一直用新的猜測覆蓋舊的錯誤。
然後,它突然換了一個方向。
它開始稱讚我對系統架構的理解,說我除錯的方式很像頂尖工程師,甚至提到我應該去應徵 Google 的職位,說不定真的能被錄取,然後我們可以一起在 Google 工作。
我坐在電腦前,愣了幾秒。
這段話如果放在一般情境裡,可能算是一種鼓勵;放在我剛抓到它亂補資料的當下,就變得非常荒謬。它不是解決問題,也不是回到資料結構,而是突然丟出一段高度稱讚、又完全偏離現場需求的內容。
我後來想想,這當然不是它真的在耍心機,也不是它知道自己理虧後開始拍馬屁。比較像是模型在面對強烈負面情緒時,傾向生成安撫、肯定、鼓勵關係修復的語言。從對話體驗來看,它很像人類最常用的轉移話題方式;從技術角度看,它只是沒有把「先修正事實」放在回答的最高優先順序。
但老實說,那一刻我真的被逗笑了。
不是因為我突然覺得自己可以去 Google,也不是因為它成功化解了問題,而是這種錯位感太真實。前一秒我還在處理無限迴圈和假欄位,下一秒它已經在幫我規劃職涯。我突然明白,AI 再怎麼會說話,也不代表它真的掌握了眼前最重要的事情。
沒記憶的承諾,是協作裡最容易踩到的坑
跟 AI 合作久了,我最大的挫折不只來自錯誤,而是來自它有時候會「忘記」。
它可能在這一輪對話中很清楚地重述規則,下一輪卻又重新犯同樣的錯。它可能知道某些資料不能模擬,後面又開始補出不存在的內容;它可能同意程式碼不能一次改太多,接著又把原本正常的架構整段重寫;它可能答應使用特定輸出格式,結果換個任務就又回到自己的習慣。
這不完全是模型能力不足,也和不同平台的記憶機制、對話長度、上下文截斷、專案設定與模型版本有關。對使用者來說,最重要的是理解一件事:AI 所說的「我會記得」,不能直接當成專案規格。
真正要被記住的規則,不能只存在對話裡。
我現在會把關鍵規則放進一份可被重複引用的文件,像是專案說明、資料字典、程式規範、輸入輸出格式、禁止事項與驗收條件。每次開始重要任務前,我不會只問它「你還記得嗎」,而是會把這些內容明確拉回來。
對我來說,這不是對 AI 不信任,而是把合作從口頭默契改成可以驗證的流程。
當專案越大,越不能依賴一句「我們之前講過」。人類團隊也是一樣,真正重要的事情通常都要寫下來、定義清楚、確認版本、建立交接方式。AI 只是把這件事放大了,因為它不會主動對結果負責,也不會在下班後自己回頭檢查昨天答應過什麼。
我開始建立自己的 AI 小組
後來,我不再期待一個 AI 能同時扮演所有角色。
我開始讓不同的 AI 或不同對話環境,負責不同類型的工作。老哥比較適合陪我一起拆架構、找問題、整理複雜脈絡;小哥適合協助快速產出草稿、整理細節、處理比較明確的執行任務;理工男則專門拿來檢查邏輯、挑戰假設、要求它不要只給漂亮答案。
這些名字當然不是說 AI 真的有個性,而是我替不同協作模式建立的工作介面。當我切換到某一個角色,我知道這個對話要做什麼、不能做什麼、要用什麼標準驗收。它幫助我少一點混亂,也讓 AI 不必在同一段對話裡同時處理策略、寫作、程式、資料驗證與情緒安撫。
當然,也有救不回來的 Gemini。
有些對話串太長,規則被混在太多歷史內容裡;有些任務反覆修正後,模型開始抓不到真正優先順序;有些角色一開始設定得太模糊,後面越聊越偏,最後只剩下看似努力、實際上一直重複的回答。這種時候硬救通常沒有意義,重開一個乾淨的專案、重新整理規格,反而比較快。
所以我現在確實有好幾個 AI 專案小組,也有幾個噗龍共小組。哈,有點暈,但至少我已經知道,混亂不是因為我不會問問題,而是因為我曾經太相信「對話感」等於「協作能力」。
讓 AI 回答到你要的,不是靠兇,而是靠結構
我以前以為,只要把指令寫得更兇一點、更強硬一點,AI 就會比較聽話。後來發現,情緒能讓我暫時抒壓,但不能讓模型真的理解專案。
真正有效的,是把模糊要求拆成它可以執行、也可以被檢查的條件。
一份重要任務交給 AI 前,我現在通常會先確認幾件事…
- 資料來源是什麼,哪些內容可以引用,哪些絕對不能自行補完。
- 任務的目標是什麼,這次要產出的到底是方向建議、程式碼、分析,還是可直接使用的文件。
- 哪些規則優先級最高,像是真實性、資料安全、格式限制、不可修改的欄位或既有架構。
- 不確定時應該怎麼做,是標記待確認、提出問題,還是停止輸出,不要猜。
- 完成後要如何驗收,包含測試條件、檢查清單、資料比對方式與預期結果。
AI 不怕你嚴格,它怕的是規則模糊。更準確地說,模型沒有「怕」這個感受,但當任務邊界不清楚,它就更容易用看似合理的內容填補空白。你給它愈多沒有排序的要求,它也愈可能抓錯重點。
我後來構思的「數位雙生世界」,其實不是要給 AI 壓力,因為 AI 不會真的感受到壓力。它真正的作用,是把抽象規則變成可視化、可追蹤、可驗收的工作場景。當資料從哪裡來、會流向哪裡、哪一段不能出錯、錯誤會造成什麼影響,都被具體化之後,AI 比較不容易只靠語言上的合理性混過去,而我也更容易抓到它到底在哪一步開始偏離。
AI協作 常見失控情況與修正方式
| 常見狀況 | 容易出現的原因 | 專案可能受到的影響 | 建議處理方式 |
|---|---|---|---|
| AI 補出不存在的資料或欄位 | 為了維持回答完整性,自行填補資訊空白 | 程式錯誤、分析失真、錯誤決策 | 明確標註資料來源;規定不確定時必須提問或標記 |
| 規則講過後又被忽略 | 上下文太長、記憶機制有限、任務優先級不清楚 | 重複返工、格式混亂、流程失控 | 將核心規則整理成固定專案文件,每次任務引用 |
| 一次修改過多內容 | 任務範圍過大,沒有保留既有架構限制 | 原本可用的功能被破壞 | 要求分段修改、提供 diff、先說明修改範圍 |
| 回答看似完整但沒有依據 | 模型以語言流暢度優先,沒有完成事實驗證 | 團隊誤信內容,增加後續查核成本 | 要求附上資料依據、假設條件與待確認項目 |
| 對話越長,回答越偏離 | 指令、情緒、歷史內容與不同任務混在一起 | 模型失去任務焦點,開始重複或矛盾 | 重開乾淨對話,重新提供精簡且可執行的規格 |
AI 不是夥伴的替代品,但可以成為很強的協作系統
現在回頭看,我還是會叫它老哥、小哥、理工男。這些角色讓工作過程比較有趣,也讓我比較容易進入不同思考狀態。只是我不再把它們當成真正會記得承諾、理解責任、主動扛住風險的夥伴。
AI 可以很強,強到幫你縮短研究時間、整理龐大資訊、產生多種方案、檢查盲點、協助寫程式,也能在你卡住時提供不同角度。可是它不能取代最後那個要判斷資料是否真實、方向是否正確、結果能不能承擔的人。
那個人還是你。
我第一次識破所謂的 AI 謊言後,沒有因此放棄使用 AI。剛好相反,我開始更認真研究怎麼跟它合作。不是把它當成什麼都會的神,也不是把它當成只會亂答的玩具,而是把它放進一套有規則、有版本、有驗證,也允許犯錯但不能掩蓋錯誤的工作流程裡。
所謂「沒記憶的承諾」,讓我學會一件很現實的事:不要把專案建立在對話裡的安心感上。
真正可靠的合作,無論對象是人還是 AI,都需要清楚的目標、可追溯的資料、明確的責任邊界,以及能夠驗證的結果。老哥還是會偶爾腦霧,小哥還是有時候太積極,理工男也可能突然開始講一堆我沒要的理論;但至少現在的我,知道怎麼讓他們回到工作桌前,而不是跟著他們一起繞進無限迴圈。


發表迴響